Auto-Clustering คืออะไร
คู่มือนี้เรียบเรียงและปรับรูปแบบสำหรับ Ruk-Com Cloud PaaS ภาพหน้าจออาจแตกต่างเล็กน้อยตามเวอร์ชันของระบบ
คลิกหรือแตะภาพหน้าจอเพื่อดูรายละเอียดขนาดจริง
วัตถุประสงค์
บทความนี้อธิบายการใช้งาน Auto-Clustering คืออะไร บน Ruk-Com Cloud PaaS โดยจัดลำดับขั้นตอนและจุดตรวจสอบสำหรับการนำไปใช้งานจริง
ก่อนเริ่มดำเนินการ
- เข้าสู่ระบบด้วยบัญชีที่มีสิทธิ์จัดการ Environment ที่เกี่ยวข้อง
- ตรวจสอบชื่อ Environment, Region และทรัพยากรเป้าหมายก่อนบันทึกการเปลี่ยนแปลง
- สำรองข้อมูลหรือกำหนดแผนย้อนกลับก่อนแก้ไขระบบ Production
ในยุคสมัยใหม่ให้ความสำคัญกับข้อมูลที่พร้อมใช้งาน ด้วยเหตุนี้จึงต้องรักษาการเข้าถึงข้อมูลโดยทันทีที่มีการแจ้งเตือนเข้ามา ดังนั้นการสร้างแต่ละวิธี แต่ละขนาดมีสำคัญต่อคำแนะนำในการกำหนดค่าคลัสเตอร์เป็นอย่างมาก การคลัสเตอร์เป็นเทคนิคของการใช้อย่างน้อย 2 อินสแตนซ์สำหรับบริการ ไม่เพียงแต่ลดความซับซ้อนแต่ยังให้ความน่าเชื่อถืออีกด้วย (ระบบสามารถทนต่อความล้มเหลวได้อย่างน้อย 1 อินสแตนซ์) อีกทั้งยังช่วยจัดการกับปริมาณที่สูงขึ้น
การกำหนดค่าคลัสเตอร์อาจเป็นวิธีการที่ท้าทายและต้องใช้เวลาค่อนข้างมาก Ruk-Com Cloud PaaS จึงให้การบริการแพลตฟอร์มสำหรับวิธีการแบ่งกลุ่มอัตโนมัติซึ่งเป็นที่นิยมเป็นอย่างมาก และสามารถแบ่งกลุ่มตามความต้องการของคุณโดยตรงจากโทโพโลยีwizard ระบบอัตโนมัติดังกล่าวจะช่วยลดความยุ่งยากและช่วยเพิ่มความเร็วในการสร้างคลัสเตอร์ที่พร้อมใช้งานจริงสำหรับงานของคุณ
การเปิดใช้งาน Auto Clustering
ในปัจจุบันเทมเพลตเหล่านี้รองรับฟีเจอร์การแบ่งกลุ่มอัตโนมัติผ่านทาง topology wizard:
แอปพลิเคชันเซิร์ฟเวอร์ -ปลาแก้ว, ปายรา, เจนกินส์, ไวลด์ฟลาย
ฐานข้อมูล SQL -MySQL, มาเรียดีบี, PostgreSQL
ฐานข้อมูล NoSQL -โซฟาเบด, MongoDB
เซิร์ฟเวอร์จัดเก็บข้อมูล -คอนเทนเนอร์จัดเก็บข้อมูลที่ใช้ร่วมกัน
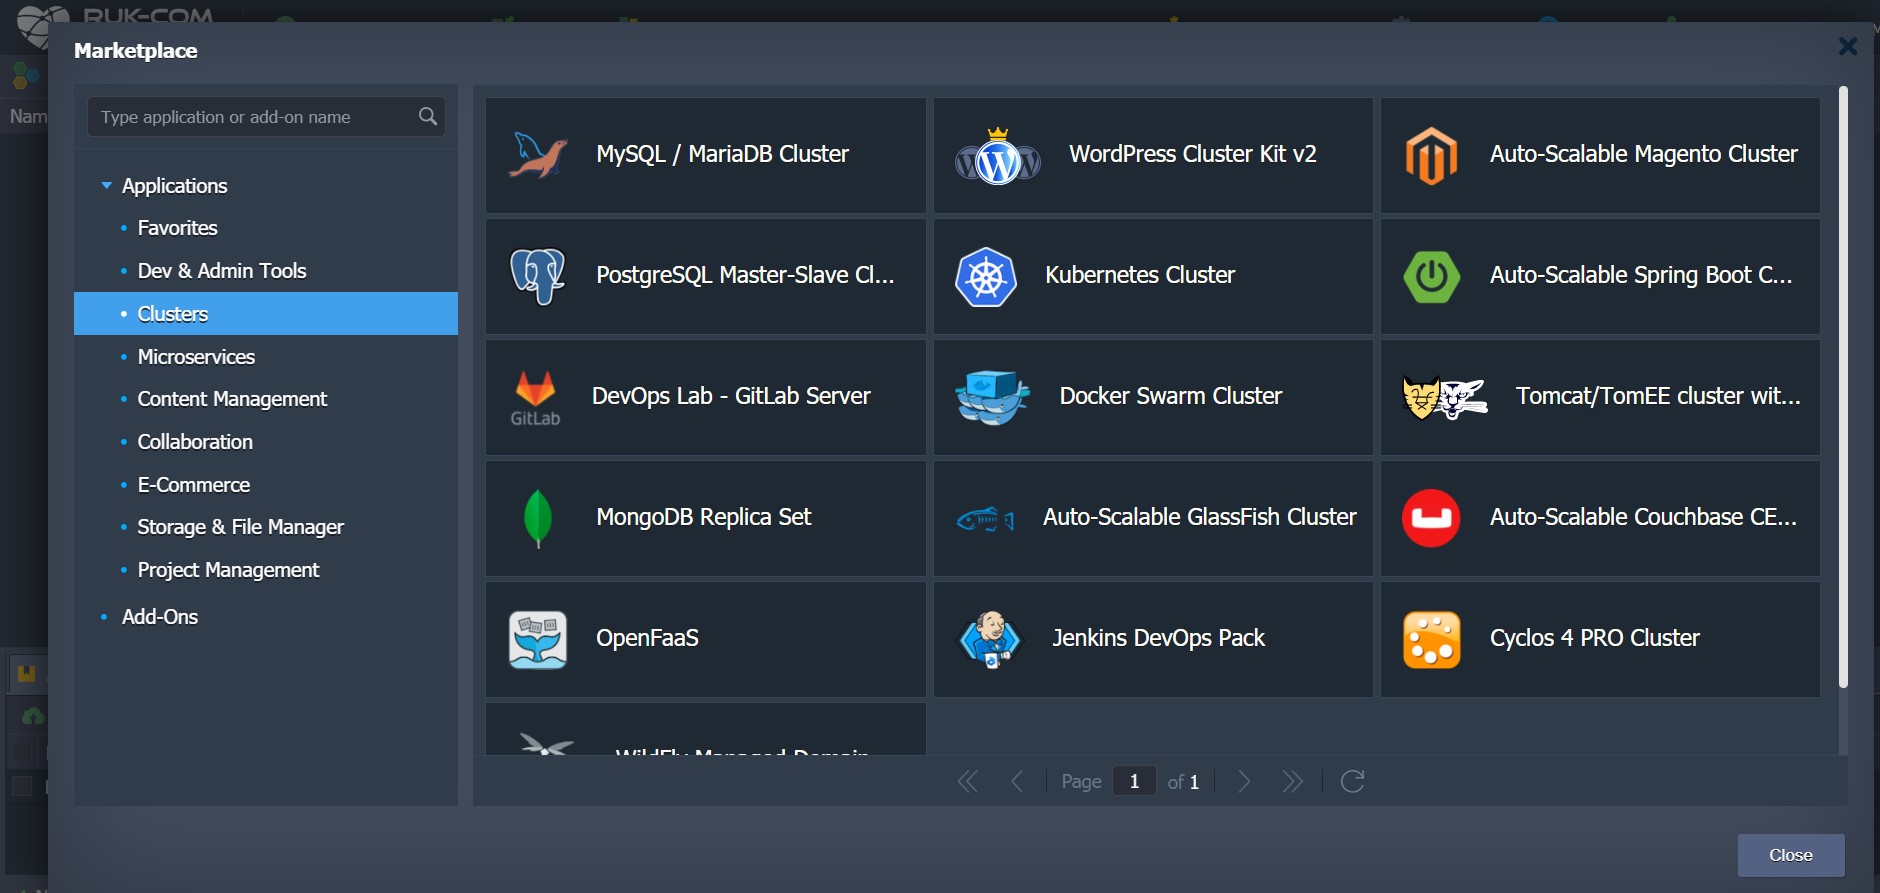
เคล็ดลับ:นอกเหนือจากตัวเลือกคลัสเตอร์ในtopology wizardคุณยังสามารถเลือกคลัสเตอร์อื่นๆได้ในRuk-Com Cloudตลาด
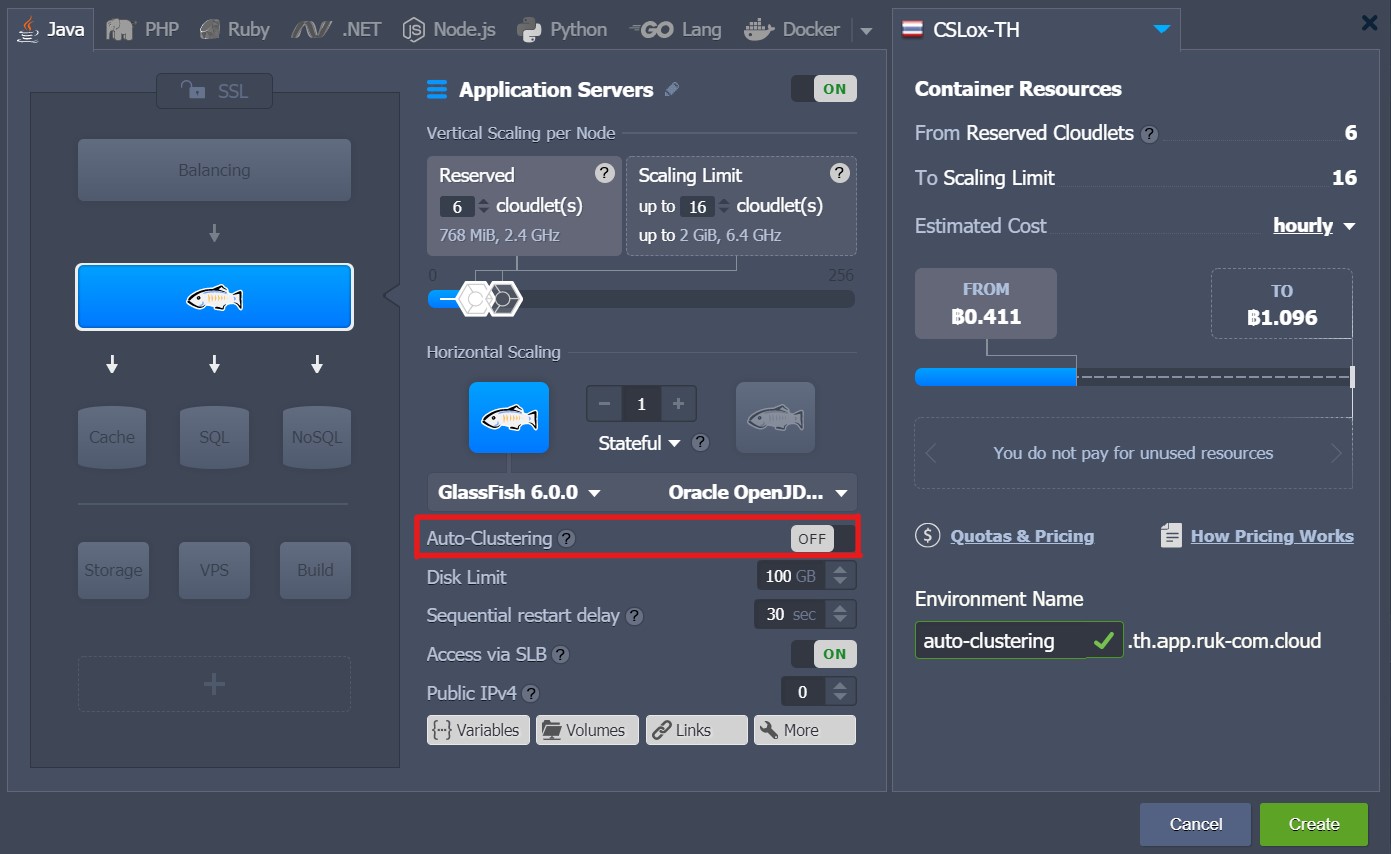
1. เลือกแอปพลิเคชันเซิร์ฟเวอร์ในลิสที่แสดงบน topology wizard ซึ่งสามารถกดเปิดสวิตช์ที่อยู่ตรงกลางของเฟรม ระบบจะแบ่งกลุ่มโดยอัตโนมัติให้อย่างเหมาะสมและพร้อมใช้งาน
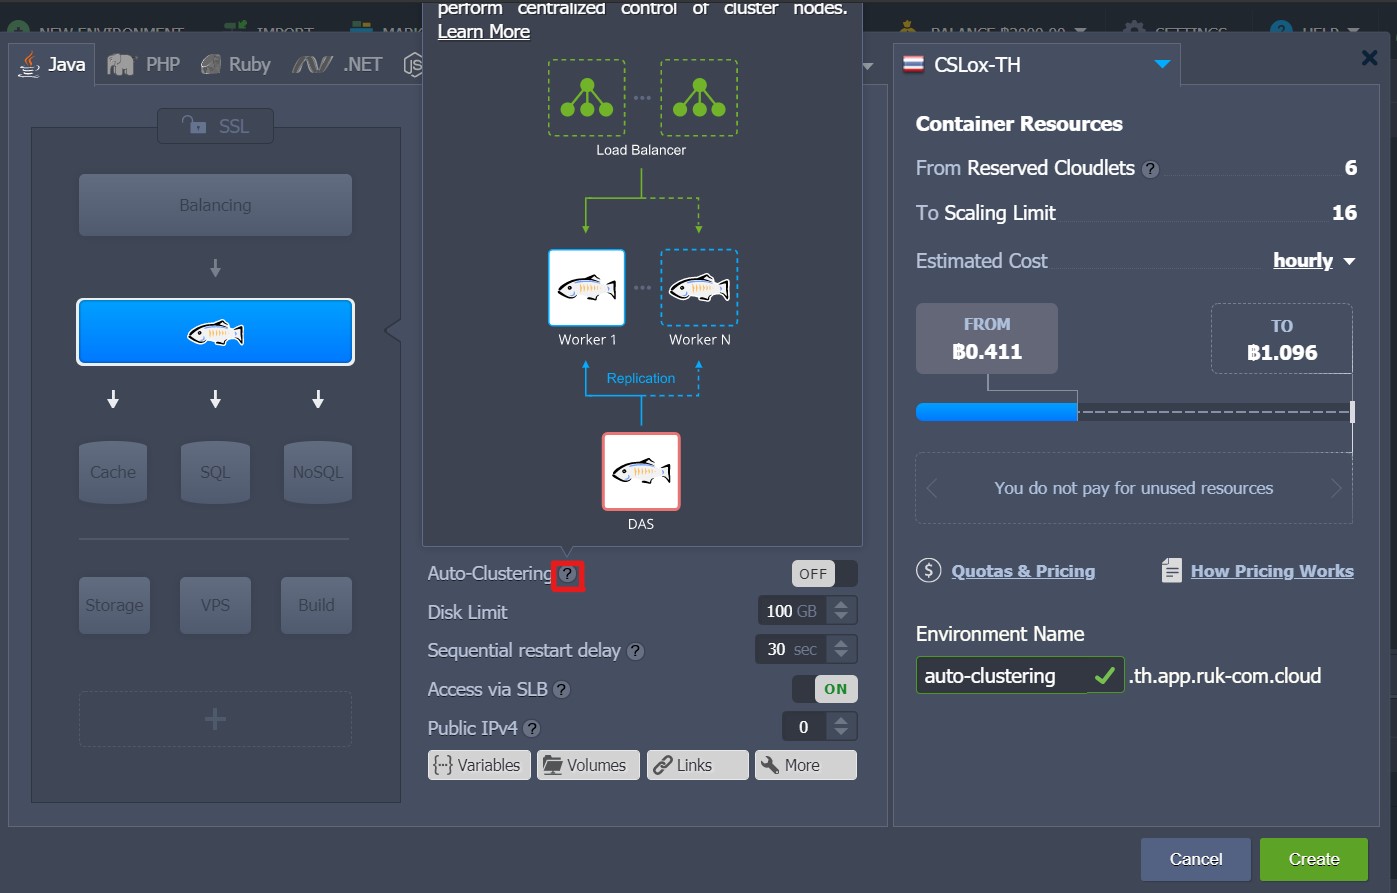
2. คุณสามารถวางเมาส์เหนือไอคอน ? เพื่อดูข้อมูลเพิ่มเติมเกี่ยวกับการแบ่งคลัสเตอร์และสามารถคลิก Learn More เพื่อดูข้อมูลเพิ่มเติมได้
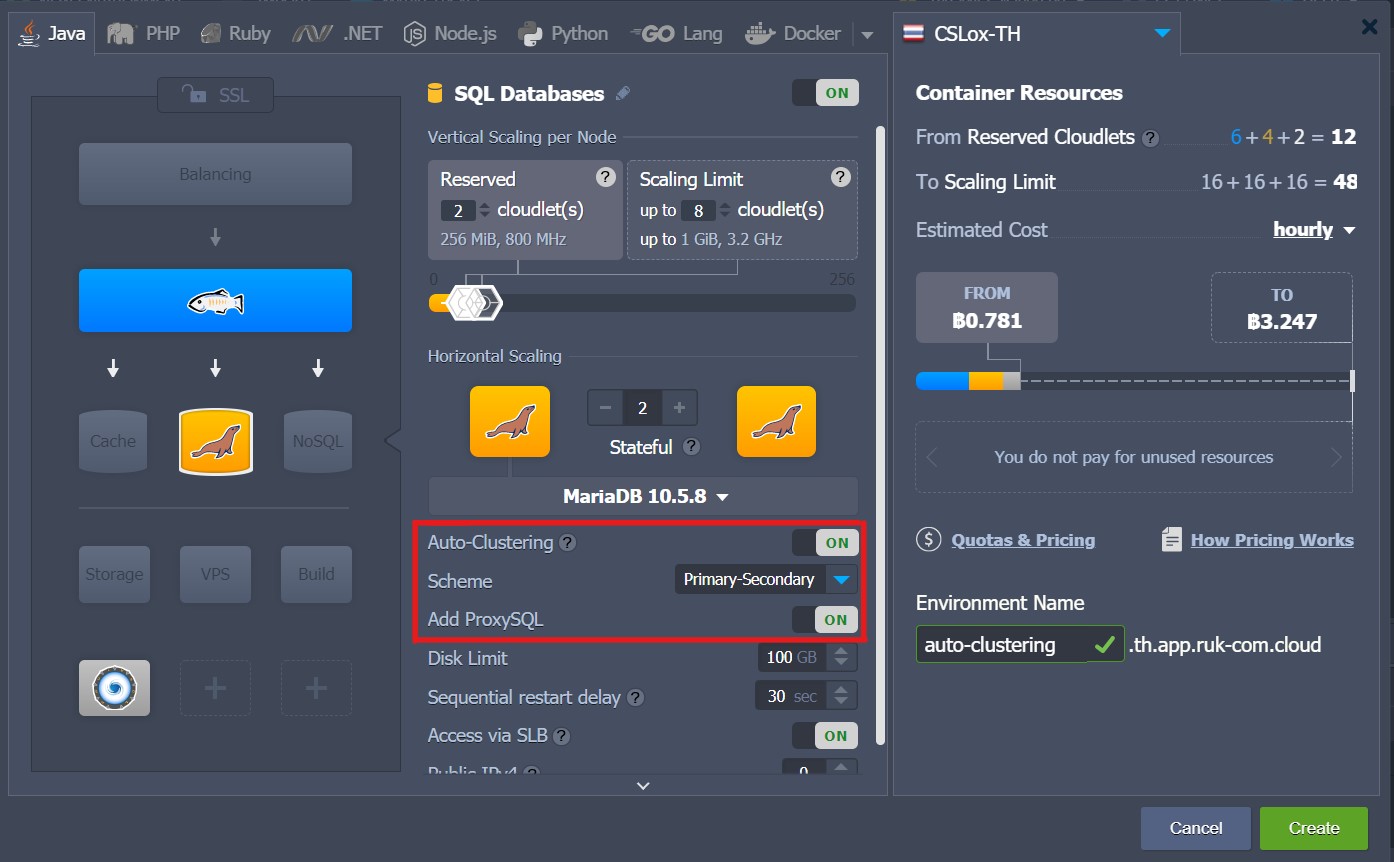
3. หลังจากเปิดใช้งาน Auto Clustering จะมีการตั้งค่าเพิ่มเติมเพื่อปรับแต่งคลัสเตอร์ ตัวอย่างเช่น MariaDB อนุญาตให้เลือก Scheme และเพิ่ม ProxySQL โดยเฉพาะสำหรับคลัสเตอร์ฐานข้อมูลนี้:
เอกสารเพิ่มเติมเกี่ยวกับการ Auto Clustering
Ruk-Com Cloud จัดเตรียมเอกสารเพิ่มเติมที่ครอบคลุมการใช้งานในหลายหัวข้อและ GitHub เกี่ยวกับแบ่งกลุ่มอัตโนมัติดังนี้:
- การจัดกลุ่มอินสแตนซ์อัตโนมัติผ่านตัวช่วยสร้างโทโพโลยี- ลิสฟีเจอร์ที่รองรับ, อธิบายการจัดการเบื้องต้นผ่าน Wizard และ Cloud Scripting
- การทำคลัสเตอร์อัตโนมัติ MariaDB/MySQL พร้อม Load Balancing และ Replication- การจัดกลุ่มและการจำลองแบบอัตโนมัติสำหรับ MariaDB และ MySQL databases เพื่อความพร้อมใช้งานและประสิทธิภาพสูง
- การทำคลัสเตอร์อัตโนมัติของ PostgreSQL พร้อมการจำลองแบบ Master-Slave แบบอะซิงโครนัส- รับข้อมูลการจำลองหลายรูปแบบอัตโนมัติภายใน Master-Slave สำหรับ PostgreSQL database
- MongoDB Replica ตั้งค่าการจัดกลุ่มอัตโนมัติเพื่อความพร้อมใช้งานและประสิทธิภาพสูง- การจัดกลุ่มและการจำลองแบบอัตโนมัติสำหรับ MongoDB databases ที่มีความซับซ้อน, ความล้มเหลวอัตโนมัติ, และความพร้อมใช้งานสูง
- GlassFish & Payara Clustering ที่พร้อมใช้งานทันที: การเรียกใช้แอปพลิเคชัน Java EE ที่พร้อมใช้งานสูงในระบบคลาวด์- แสดงวิธีการตั้งค่าคลัสเตอร์ที่พร้อมใช้งานด้วย GlassFish & Payara Micro และ Java EE สำหรับการรันแอปพลิเคชัน
- โฮสติ้งคลัสเตอร์ Jenkins เพื่อการบูรณาการและการส่งมอบอย่างต่อเนื่อง (CI/CD)- การรวมกลุ่มอัตโนมัติอย่างต่อเนื่องและส่ง Java แอปพลิเคชันโดยใช้ Jenkins master-slave ที่มีการกำหนดค่าไว้ล่วงหน้าแล้ว
- โดเมนที่จัดการ WildFly ในคอนเทนเนอร์: การทำคลัสเตอร์ขนาดเล็กและการปรับขนาดอัตโนมัติ- วีธีการขยาย WildFly จากเซิร์ฟเวอร์แบบ standalone ไปยังคลัสเตอร์ในโหมดโดเมนที่มีการจัดการสำหรับการเรียกใช้ cloud-native microservices
- การทำคลัสเตอร์อัตโนมัติของคอนเทนเนอร์ที่เก็บข้อมูลที่ใช้ร่วมกัน- รองรับการกำหนดค่าที่มีความน่าเชื่อถือด้วย AutoFS, NFSv4 และ GlusterFS
- Ruk-Com Cloud Packaged Solutions Collection บน GitHub- วิธีการจัดเก็บแบบอัตโนมัติของ Ruk-Com Cloud รวมไปถึงการแบ่งกลุ่มอัตโนมัติ (เช่น db-clustering, wildfly, glassfish และฐานข้อมูลอื่นๆ)