
Failover Protection ด้วย Traffic Distributor
คู่มือนี้เรียบเรียงสำหรับ Ruk-Com PaaS หน้าจอและตัวเลือกอาจแตกต่างตามเวอร์ชันและสิทธิ์ของบัญชี
ตรวจสอบ Environment, Region, สิทธิ์บัญชี และสำรองค่าปัจจุบันก่อนดำเนินการกับระบบจริง
ตรวจสอบชื่อเมนู ตัวเลือก และข้อกำหนดล่าสุดจากเนื้อหาภาษาอังกฤษในหน้าเดียวกันก่อนดำเนินการกับระบบจริง
วัตถุประสงค์
บทความนี้อธิบาย Failover Protection ด้วย Traffic Distributor บน Ruk-Com Cloud PaaS โดยจัดลำดับขั้นตอนและจุดตรวจสอบสำหรับการนำไปใช้งานจริง
ก่อนเริ่มดำเนินการ
- เข้าสู่ระบบด้วยบัญชีที่มีสิทธิ์จัดการ Environment ที่เกี่ยวข้อง
- ตรวจสอบชื่อ Environment, Region และ Resource เป้าหมายก่อนบันทึกการเปลี่ยนแปลง
- สำรองข้อมูลหรือกำหนดแผนย้อนกลับก่อนแก้ไขระบบ Production
Ruk-Com Cloud Traffic Distributor ช่วยป้องกัน failover ขั้นสูงได้อย่างง่ายดายด้วยความช่วยเหลือของโมดูลการตรวจสอบสภาพในตัวซึ่งจะทดสอบ backend อย่างสม่ำเสมอโดยอัตโนมัติเพื่อความพร้อมใช้งานและแยกส่วนที่ไม่พร้อมใช้งานออกจากการกำหนดเส้นทาง ฟังก์ชันนี้จะเปิดใช้งานโดยค่าเริ่มต้น อย่างไรก็ตาม คุณสามารถปรับการทำงานของโมดูลนี้ได้หากต้องการ เพียงทำตามขั้นตอนด้านล่าง
1. ไปที่แผงควบคุม NGINXการกำหนดค่าและไปที่ไฟล์/etc/NGINX/NGINX-Ruk-Com PaaS.confภายในราก:
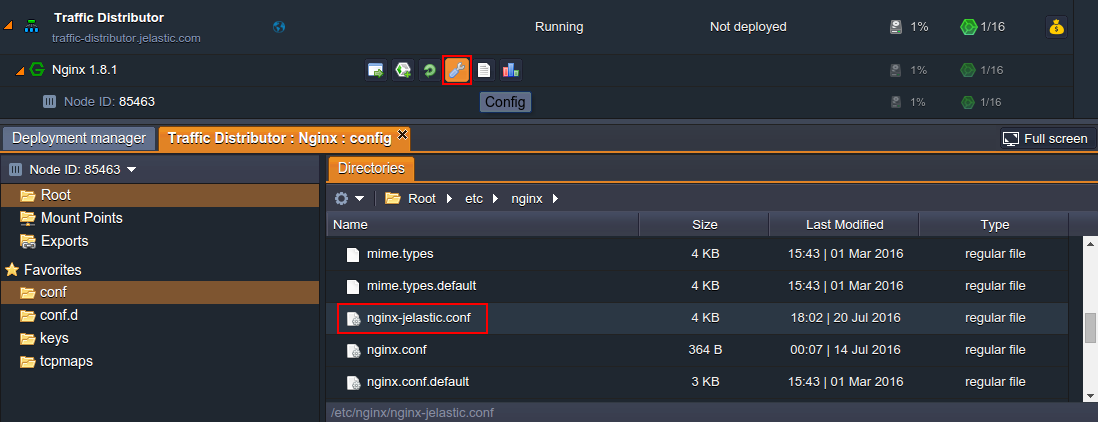
ดับเบิลคลิกเพื่อเปิดในแท็บใหม่สำหรับแก้ไข
2. เลื่อนลงประมาณบรรทัดที่ 50 ซึ่งมีการประกาศการกำหนดค่า add-on ค้นหาและตรวจสอบโมดูลที่จำเป็นภายในส่วนต้นน้ำทั่วไปโดยมี Parameter ต่อไปนี้ (โดยที่ Parameter ในวงเล็บสี่เหลี่ยมเป็นตัวเลือก):
check interval={interval} fall={fail_count} rise={rise_count} [timeout={timeout}] [default_down={true/false}] [port={port}] [type={type}]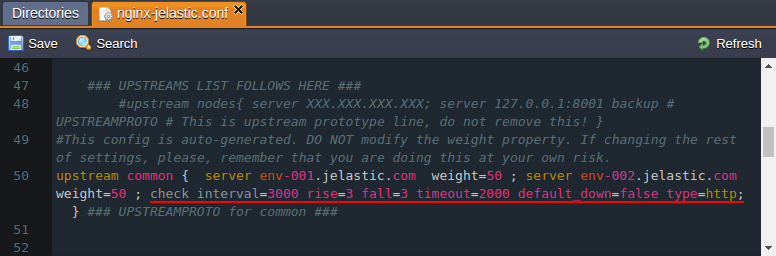
โดยที่:
- {ช่วงเวลา}- delay ระหว่างการตรวจสอบ requests สองครั้งติดต่อกัน; ตั้งค่าเป็น milliseconds
- {ล้มเหลว_นับ}- จำนวนของการตรวจสอบความล้มเหลว หลังจากนั้น Server จะถูกทำเครื่องหมายว่าไม่พร้อมใช้งานไม่พร้อมใช้งาน
- {เพิ่มขึ้น_นับ}- จำนวนของการตรวจสอบที่สำเร็จหลังจากนั้น Server จะถูกทำเครื่องหมายว่าขึ้นและทำงาน
- {หมดเวลา}- หมดเวลา (milliseconds) ตรวจสอบสภาพโมดูลที่กำลังรอการตอบกลับจาก backend ก่อนที่ตรวจสอบ request จะถือว่าล้มเหลว
- {จริง/เท็จ}- ตั้งค่าสถานะเริ่มต้น (ขึ้นหรือลงตามลำดับ) ของ backends ทั้งสอง (เช่น จนกว่าจะผ่านจำนวนการตรวจสอบที่สอดคล้องกัน) ระบุเป็น true โดยปริยาย
- {Port}- หมายเลข Port ที่จะใช้ในขณะที่เชื่อมต่อกับ backend เพื่อดำเนินการตรวจสอบสภาพโดยค่าเริ่มต้นจะถูกตั้งค่าเป็น 0 ซึ่งหมายความว่า Port ของ Server เริ่มต้น (ตาม Protocol ที่ตั้งไว้) จะถูกใช้
- {ประเภท}- ประเภท Protocol ที่จะใช้สำหรับการตรวจสภาพ (เช่น เพื่อวิเคราะห์ว่า backend ทำงานหรือไม่)
- ทีพีพี- การเชื่อมต่อTCPsocket อย่างง่าย
- ssl_hello- ส่ง Packageลูกค้าสวัสดีSSL ซึ่งควรตอบกลับด้วยข้อความServer สวัสดี
- http- ส่ง PackageHTTPrequest เพื่อรับและวิเคราะห์การตอบสนอง (response)
- MySQL- เชื่อมต่อกับMySQLserver และตอบรับคำทักทาย
- อาจ- ส่ง Package AJP Cping เพื่อรับและแยกวิเคราะห์การตอบสนองของ Cpong
- รวดเร็ว cgi- ส่งคำขอFastCGIเพื่อรับและวิเคราะห์การตอบสนอง
ตามที่ตั้งค่าในภาพด้านบน backend ทั้งสองจะได้รับการตรวจสอบ HTTP response ปกติ (เช่น200status code) ซึ่งหมายความว่ามีการดำเนินการตามคำขอ) ทุก 3 วินาทีหากการตรวจสอบแล้วล้มเหลว 3 ครั้งติดต่อกัน Backend ที่เกี่ยวข้องจะถูกทำเครื่องหมาย "down" และแยกออกจากเส้นทาง เพื่อให้คำขอทั้งหมดไปที่ environment ที่สองและเมื่อ Server ที่ล่มทำงานอีกครั้ง Server นั้นจะถูกเพิ่มเข้าไปใหม่โดยอัตโนมัติ (หลังคำขอสำเร็จติดต่อกัน 3 ครั้ง) ในรายการ backends
3. หลังจากบันทึกการเปลี่ยนแปลงที่กำหนดค่าไว้ใน NGINX balancer การเปลี่ยนแปลงเหล่านี้สามารถใช้ได้โดยไม่ต้อง RestartServer ทั้งหมด (และเพื่อหลีกเลี่ยงโปรเจกต์หยุดทำงาน) ผ่านการโหลดซ้ำผ่านตัวเลือก Reload กำหนดค่า uration ที่เมนู add-on
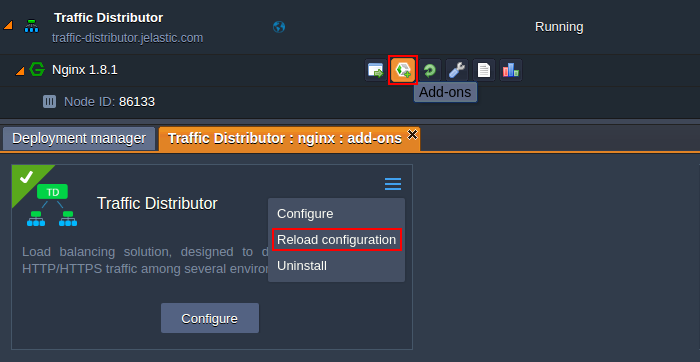
ยืนยันการตัดสินใจของคุณผ่านป๊อปอัปที่ปรากฎและในไม่กี่วินาทีการตั้งค่า failover protection ใหม่ของคุณจะมีผลบังคับใช้