
Auto-Clustering ผ่าน Topology Wizard
คู่มือนี้เรียบเรียงสำหรับ Ruk-Com PaaS หน้าจอและตัวเลือกอาจแตกต่างตามเวอร์ชันและสิทธิ์ของบัญชี
ตรวจสอบ Environment, Region, สิทธิ์บัญชี และสำรองค่าปัจจุบันก่อนดำเนินการกับระบบจริง
วัตถุประสงค์
บทความนี้อธิบาย Auto-Clustering ผ่าน Topology Wizard บน Ruk-Com Cloud PaaS โดยจัดลำดับขั้นตอนและจุดตรวจสอบสำหรับการนำไปใช้งานจริง
ก่อนเริ่มดำเนินการ
- เข้าสู่ระบบด้วยบัญชีที่มีสิทธิ์จัดการ Environment ที่เกี่ยวข้อง
- ตรวจสอบชื่อ Environment, Region และ Resource เป้าหมายก่อนบันทึกการเปลี่ยนแปลง
- สำรองข้อมูลหรือกำหนดแผนย้อนกลับก่อนแก้ไขระบบ Production
Ruk-Com Cloud PaaS จัดเตรียมการจัดกลุ่มอัตโนมัติตามความต้องการของการจัดการ Template โดยระบบอัตโนมัติจะช่วยลดความยุ่งยากและเพิ่มความเร็วในการสร้าง Cluster ที่พร้อมสำหรับการผลิตโปรเจกต์ที่เชื่อถือได้
ในส่วนด้านล่างเราจะอธิบายตามหัวข้อต่อไปนี้:
- การรองรับ Stack (สำหรับการ Cluster โดยเฉพาะ)
- การจัดการ Cluster อัตโนมัติ
- การใช้ cloud scripting
Template ที่รองรับการทำ Cluster อัตโนมัติ
ในปัจจุบัน Template ต่อไปนี้รองรับฟีเจอร์การทำ Cluster ที่เพิ่มใหม่ (พร้อมกับ Stack ที่จะเพิ่มในอนาคต):
- ApplicationServer-ทอมแคท/ทอมอี, ปลาแก้ว, ปายรา, เจนกินส์, ไวลด์ฟลาย
- Database SQL-MySQL, มาเรียดีบี, PostgreSQL
- Database NoSQL-โซฟาเบด, MongoDB
- Server จัดเก็บข้อมูล-Container จัดเก็บข้อมูลที่ใช้ร่วมกัน
เคล็ดลับ:ผู้ให้บริการ Host ของคุณสามารถกำหนดค่าและใช้การจัดกลุ่มอัตโนมัติสำหรับ Stack เพิ่มเติมบางตัวที่ไม่ได้กำหนดไว้ในรายการ
ทอมแคท/ทอมอี
Tomcat/TomEE cluster ที่มีความพร้อมใช้งานสูงสามารถปรับ balance load ข้ามการคำนวณ Node เพื่อเพิ่มประสิทธิภาพและความยืดหยุ่น การจัดเตรียมการจำลอง Session, การจำลองแบบ context attribute, และการ Deploy ไฟล์ WAR ทั่วทั้ง Cluster
เพิ่มเติม:ฟีเจอร์การจัดกลุ่มอัตโนมัติสำหรับ Tomcat และ TomEE จะมีให้ใช้งานตั้งแต่ Stack เวอร์ชันต่อไปนี้
แมวตัวผู้- 10.0.5; 9.0.45; 8.5.64; 7.0.108
ทอมอี- 9.0.0-M3; 8.0.5
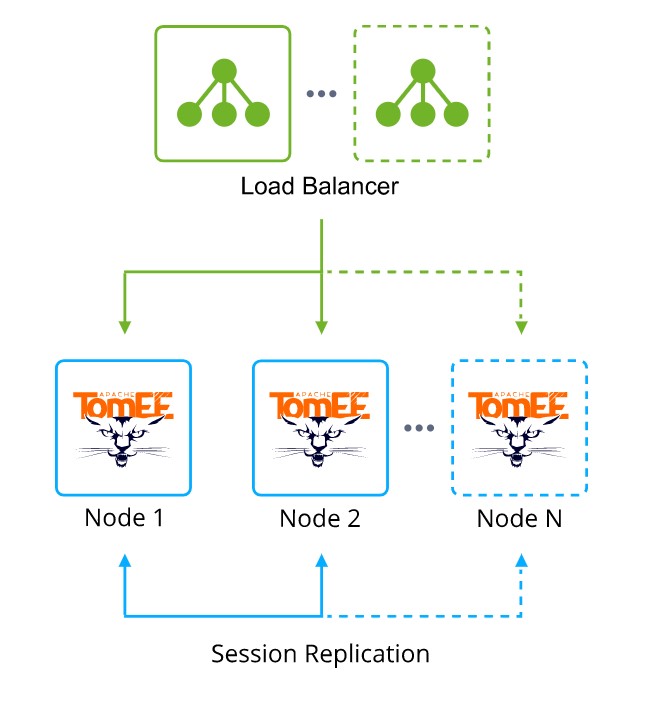
เรียนรู้เพิ่มเติมเกี่ยวกับ Tomcat/TomEE >>
ปลาแก้ว
การเชื่อมต่อระหว่าง GlassFish Server ด้วยการจำลอง Session ที่กำหนดค่าไว้ล่วงหน้าและการทำโหลดบาลานซ์
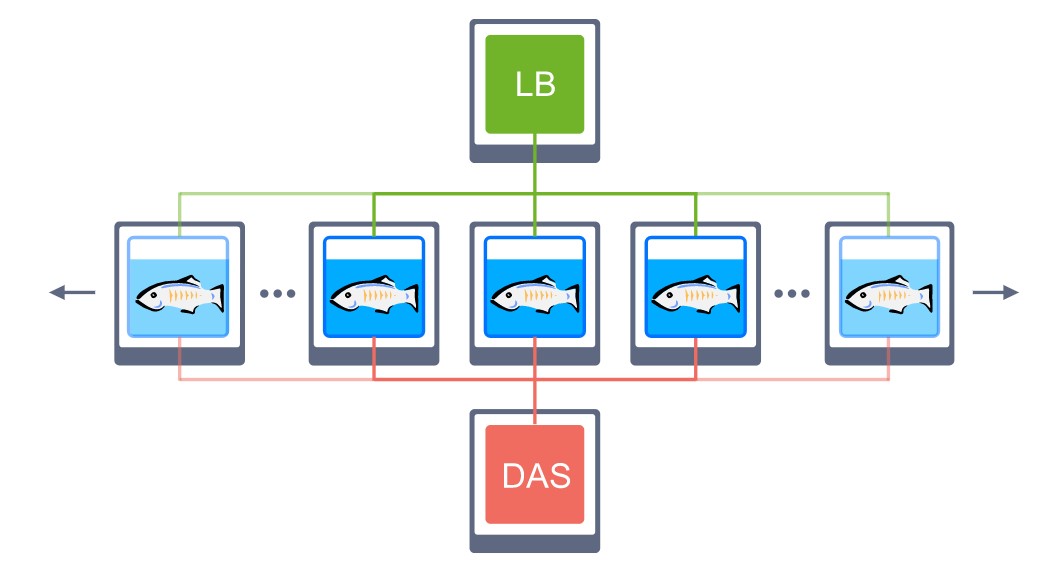
เรียนรู้เพิ่มเติมเกี่ยวกับ GlassFish >>
ปายรา
การเชื่อมต่อระหว่าง Payara Server ด้วยการจำลอง Session ที่กำหนดค่าไว้ล่วงหน้าและการทำโหลดบาลานซ์
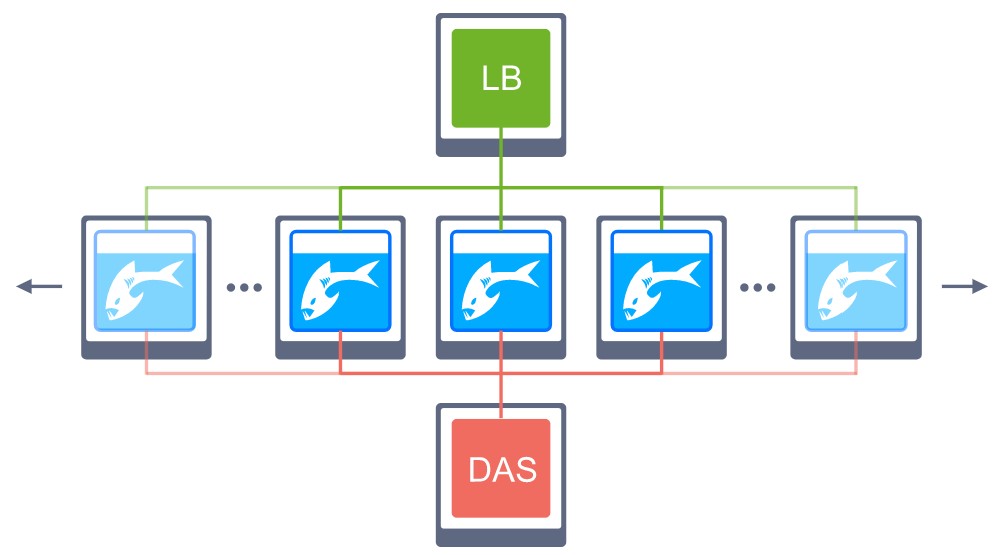
เรียนรู้เพิ่มเติมเกี่ยวกับ Payara >>
เจนกินส์
Master Jenkins node ในโหมด master-slave ที่ปรับขนาดผู้ใช้งาน Java Engine โดยอัตโนมัติและติดตั้ง Plugin ล่วงหน้าเพื่อรองรับการสร้างและการ deploy ระบบอัตโนมัติสำหรับการจัดตั้ง continuous integration (CI) และ continuous delivery (CD) pipelines
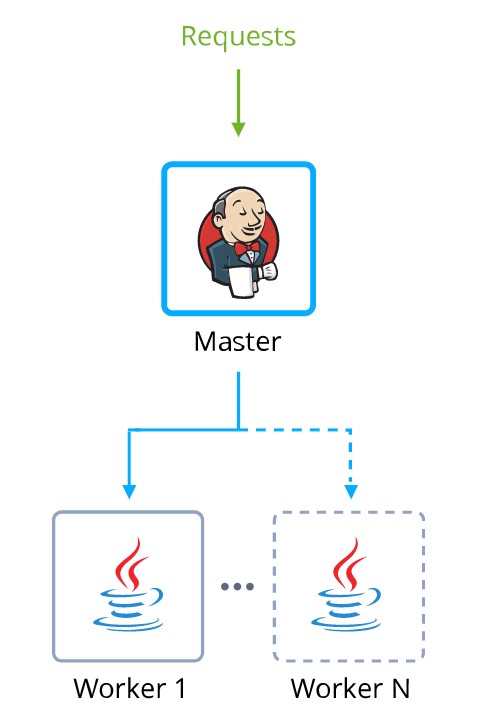
เรียนรู้เพิ่มเติมเกี่ยวกับ Jenkins >>
ไวลด์ฟลาย
WildFly nodes ในโหมด Domain ที่เปิดใช้งาน Cluster เพื่อให้มีความพร้อมใช้งานสูงและรับประกันประสิทธิภาพอย่างต่อเนื่องของ Application ที่ deploy Java EE
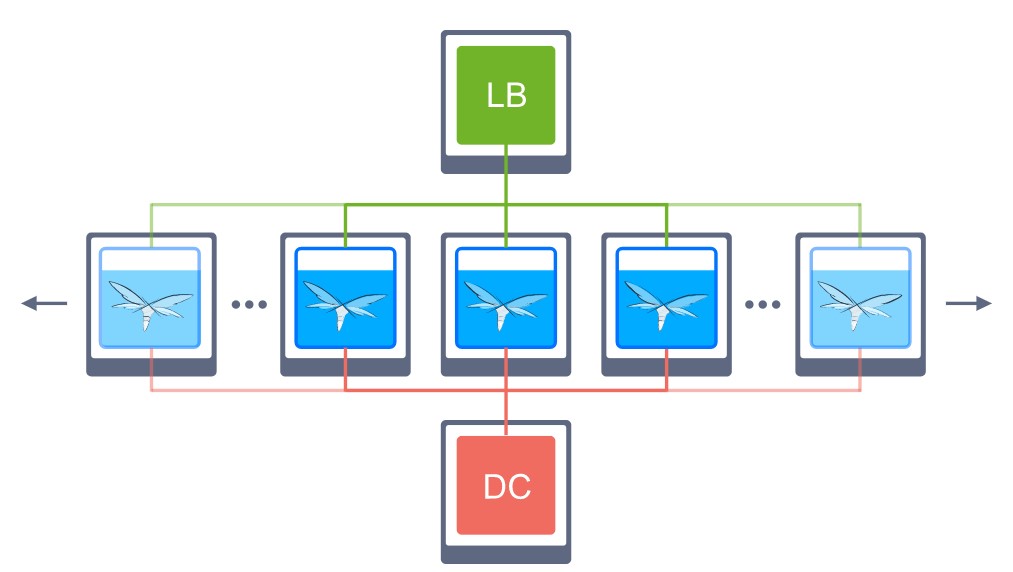
เรียนรู้เพิ่มเติมเกี่ยวกับ WildFly >>
MySQL
การ Cluster อัตโนมัติจัดเตรียมให้สำหรับ MySQL เวอร์ชัน5.7.xและ8.xเท่านั้น
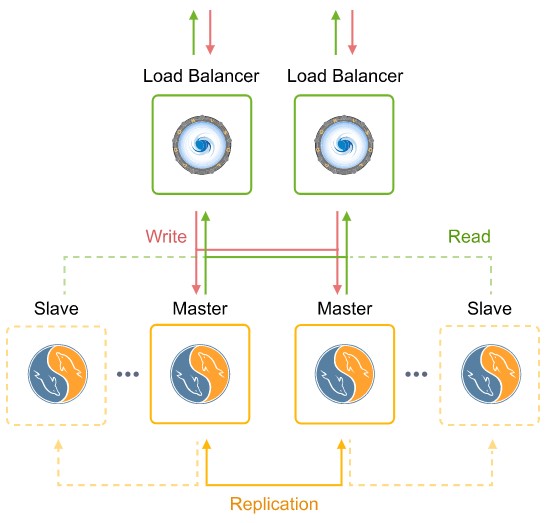
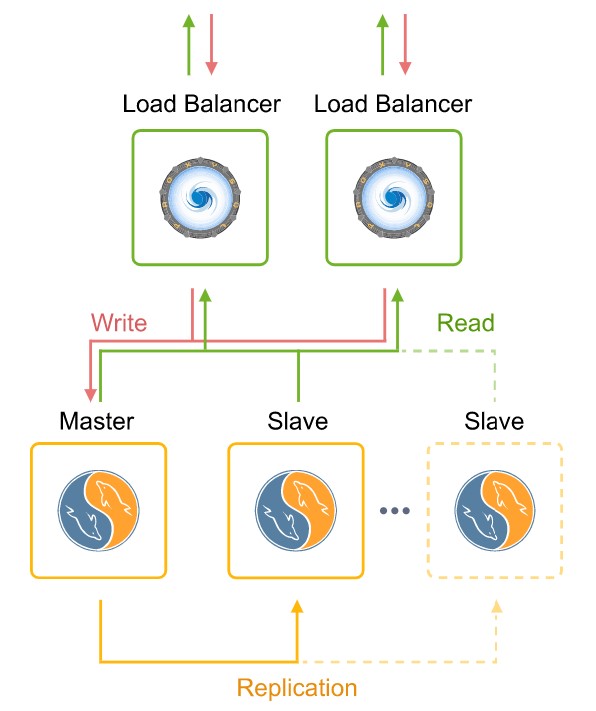
การ Cluster database โดยอัตโนมัติด้วยการจำลองแบบกำหนดค่าไว้ล่วงหน้าและการค้นหา Node อัตโนมัติ คุณสามารถเลือกแบบแผนต่อไปนี้ได้ตามประเภทที่คุณต้องการ:
- อาจารย์-อาจารย์กับ Extra Slaves
การจำลองแบบที่กำหนดค่าไว้ล่วงหน้าด้วย master databases 2 ตัวเชื่อมต่อกัน ในระหว่าง Horizontal ScalingCluster จะขยายด้วย slave nodes เพิ่มเติม
- มาสเตอร์-สเลฟกับ Extra Slaves
การจำลองแบบที่กำหนดค่าไว้ล่วงหน้าด้วย 1 master และ 1 slave database ในระหว่าง Horizontal ScalingCluster จะขยายด้วย slave nodes เพิ่มเติม
เรียนรู้เพิ่มเติมเกี่ยวกับ MySQL >>
มาเรียดีบี
การ Cluster อัตโนมัติจัดเตรียมให้สำหรับ MariaDB เวอร์ชัน10.xเท่านั้น
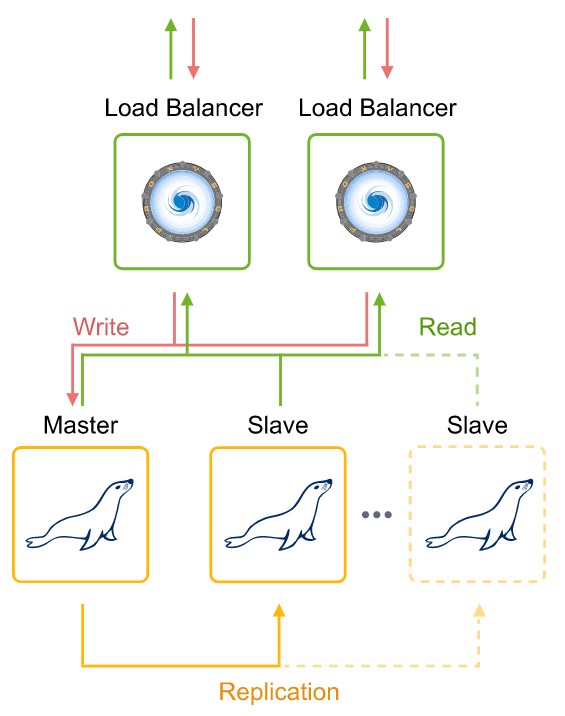
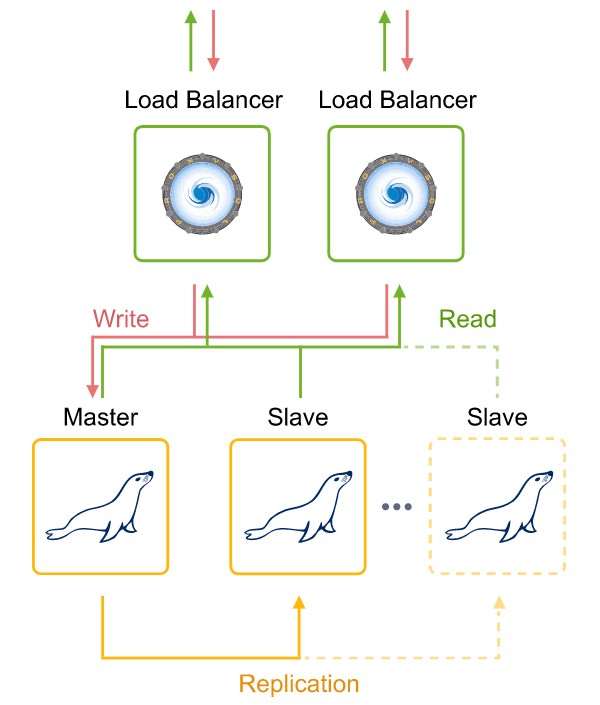
การ Cluster database โดยอัตโนมัติด้วยการจำลองแบบกำหนดค่าไว้ล่วงหน้าและการค้นหา Node อัตโนมัติ คุณสามารถเลือกแบบแผนต่อไปนี้ได้ตามประเภทที่คุณต้องการ:
- อาจารย์-อาจารย์กับ Extra Slaves
การจำลองแบบที่กำหนดค่าไว้ล่วงหน้าด้วย master databases 2 ตัวเชื่อมต่อกัน ในระหว่าง Horizontal ScalingCluster จะขยายด้วย slave nodes เพิ่มเติม
- มาสเตอร์-สเลฟกับ Extra Slaves
การจำลองแบบที่กำหนดค่าไว้ล่วงหน้าด้วย 1 master และ 1 slave database ในระหว่าง Horizontal ScalingCluster จะขยายด้วย slave nodes เพิ่มเติม
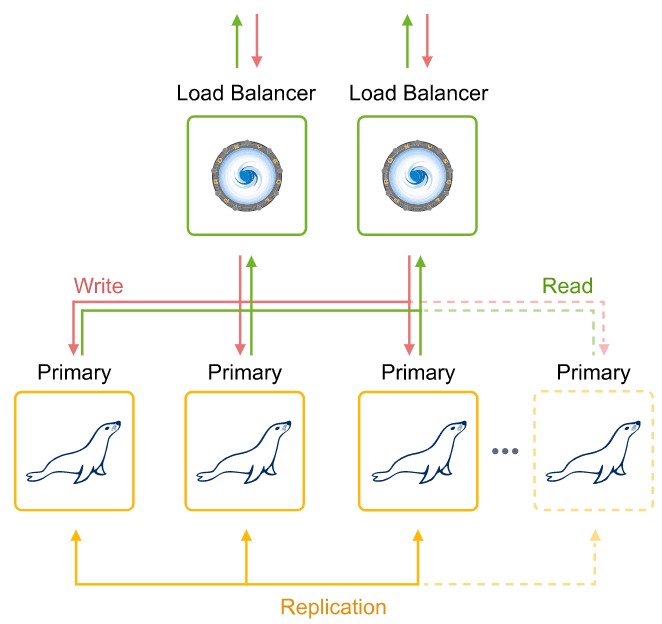
- กาเลราCluster
Server ทั้งหมดสามารถยอมรับการอัปเดตได้แม้ว่าออกพร้อมกัน
เรียนรู้เพิ่มเติมเกี่ยวกับ MariaDB >>
PostgreSQL
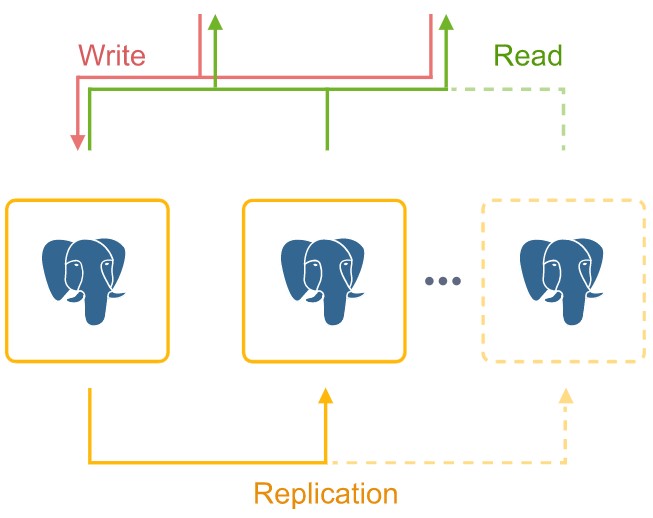
PostgreSQL database cluster ที่กำหนดค่าไว้ล่วงหน้าพร้อมการจำลอง master-slave แบบ asynchronous และการเพิ่ม Node ใหม่โดยอัตโนมัติใน Cluster (slaves)
เรียนรู้เพิ่มเติมเกี่ยวกับ PostgreSQL >>
โซฟาเบด
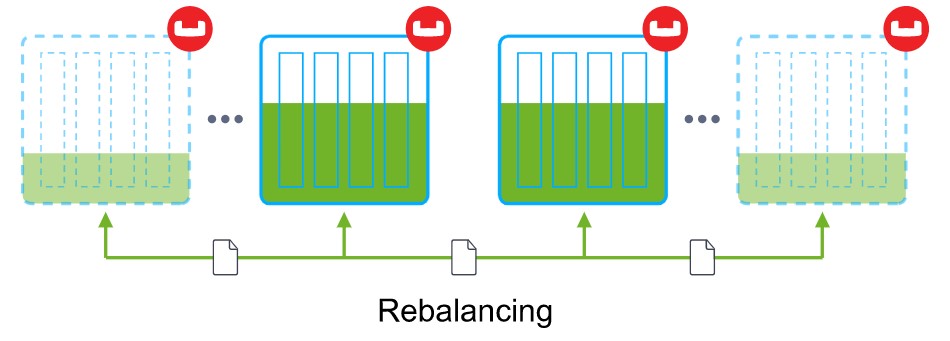
Couchbase servers ที่เชื่อมต่ออัตโนมัติพร้อมกับการสเกลอัตโนมัติและการปรับสมดุลใหม่เพื่อให้ระบบจัดเก็บข้อมูลที่มีความพร้อมใช้งานสูงเพียงระบบเดียว
เรียนรู้เพิ่มเติมเกี่ยวกับ Couchbase >>
MongoDB
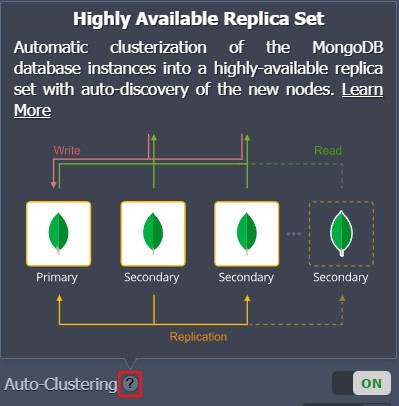
การกำหนดค่าอัตโนมัติของเซตแบบจำลอง MongoDB ที่มีความพร้อมใช้งานสูงและเชื่อถือได้พร้อมทั้งการค้นหา Node ใหม่โดยอัตโนมัติ
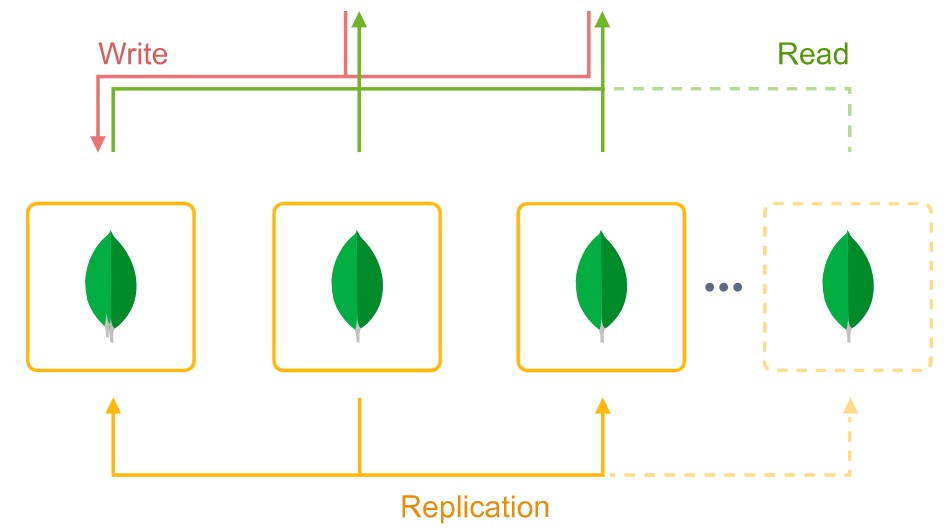
เรียนรู้เพิ่มเติมเกี่ยวกับ MongoDB >>
Container จัดเก็บข้อมูลที่ใช้ร่วมกัน
Cluster การจัดเก็บข้อมูลที่กำหนดค่าโดยอัตโนมัติและเชื่อถือได้ (volume ที่ทำซ้ำ) ขึ้นอยู่กับโซลูชันClusterซึ่งรับประกันความปลอดภัยของข้อมูล ในกรณีที่ Node เกิดความล้มเหลว Node หนึ่งหรือหลาย Node AutoFS client จะสลับไปยัง Instance ที่ทำงานโดยอัตโนมัติ ทำให้พื้นที่จัดเก็บมีความพร้อมใช้งานสูง
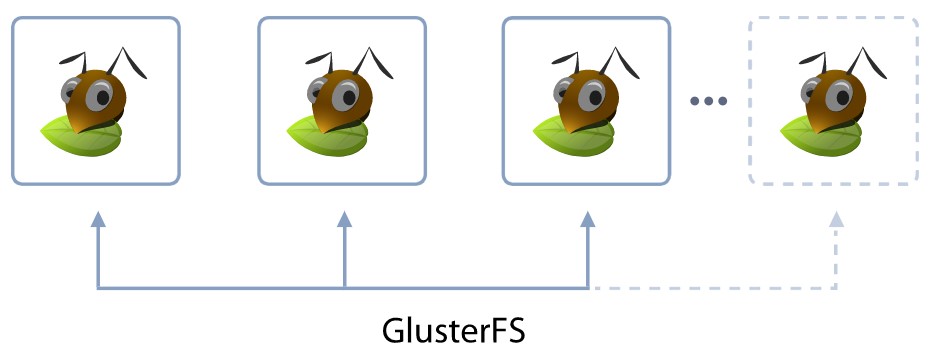
เรียนรู้เพิ่มเติมเกี่ยวกับ Shared Storage Container >>
การจัดการ Cluster อัตโนมัติ
1. ฟีเจอร์ Auto-Clustering สามารถเปิดใช้งานสำหรับกลุ่ม Node ผ่านปุ่มสลับ ON/OFF ที่ส่วนกลางของ topology wizard (หากมีให้สำหรับ Stack ที่เลือก)
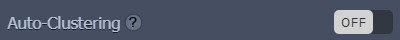
- เคล็ดลับ:ตัวเลือกการ Cluster อัตโนมัติขึ้นอยู่กับการใช้งานโดยเฉพาะ
- คำสั่งเปิดใช้งาน (สำหรับDatabase โซฟา)

- การตั้งค่าบางอย่างเพิ่มเติม (เช่น cluster scheme และ ProxySQL load balancer สำหรับ MySQL database)
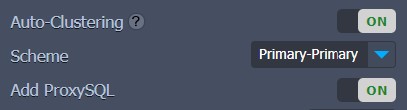
- การจำกัดจำนวน Node ต่ำสุดและสูงสุดและโหมดการปรับขนาด (เช่น สำหรับประเภท MariaDB Galera)
2. ข้อมูลเพิ่มเติมเกี่ยวกับ Cluster ที่จะสร้าง คุณสามารถวางเมาส์เหนือเครื่องหมายคำถามถัดจาก Auto-Clustering ภายในกรอบป๊อปอัปที่เหมาะสมคุณจะเห็นคำอธิบายสั้นๆซึ่งจะประกอบด้วยแผนผัง topology
เคล็ดลับ:ข้อมูลเพิ่มเติมเกี่ยวกับประเภทของ database cluster สามารถดูได้โดยวางเมาส์เหนือ Scheme ที่เหมาะสม: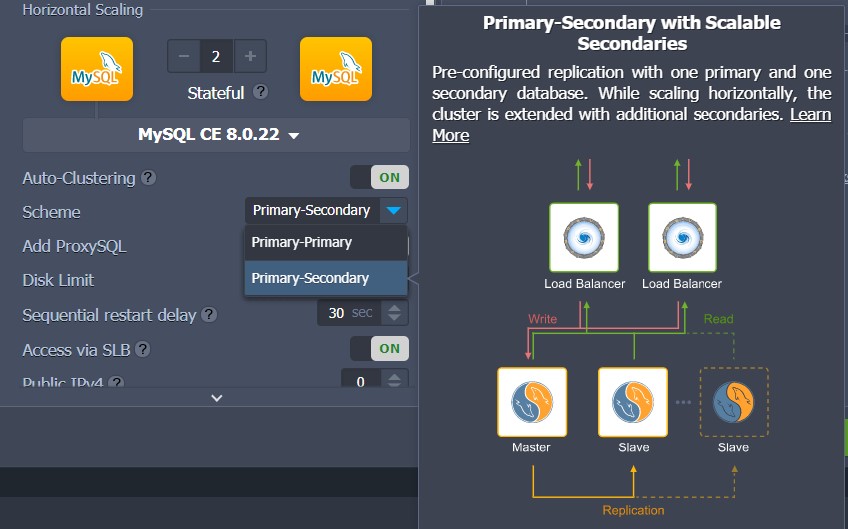
3. การตั้งค่าอื่นๆ สามารถกำหนดค่าได้เช่นเดียวกับ environment ทั่วไป
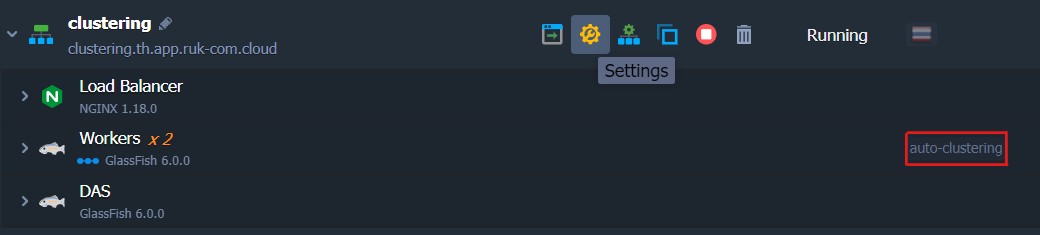
หมายเหตุ:หลังจากกำหนดค่าแล้วการทำ Cluster อัตโนมัติจะไม่สามารถปิดใช้งานได้จาก topology wizard
คุณสามารถติดตาม logs การกำหนดค่า Cluster ผ่าน Platform คอนโซล:
https://app.{Platform Domain}/คอนโซล
การตั้งค่า Cluster อัตโนมัติด้วย Cloud Scripting
ในการกำหนดการตั้งค่า Cluster อัตโนมัติใน JPS solutions คุณสามารถใช้คุณสมบัติของ Cluster ใหม่ได้ยกตัวอย่างเช่น:
1. เปิดหรือปิดใช้งานการทำ Cluster อัตโนมัติสำหรับ Layer เฉพาะ
"nodeGroup": "couchbase",
"cluster": true | false
2. Parameter เพิ่มเติมสำหรับการทำ Cluster อัตโนมัติสามารถระบุได้ด้วยวิธีต่อไปนี้ (ตัวอย่างเช่น เลือก database cluster scheme):
"nodeGroup": "mysql",
"cluster": {
  "scheme": "master"
}
3. หากจำเป็น JPS ประจักษ์เริ่มต้นมีขั้นตอนการทำ Cluster ที่สามารถแทนที่ด้วยรายการแบบกำหนดเองได้:
"nodeGroup": "mysql",
"cluster": {
 "jps": "http://.../custom-manifest.jps",
 "settings": {
   "scheme": "master"
 }
}
4. ขึ้นอยู่กับความต้องการของการ Cluster โดยเฉพาะซึ่งอาจจำเป็นต้องมีการจำกัด topology (เช่น จำนวน Node ต่ำสุด/สูงสุด โหมดการปรับขนาด ฯลฯ) จะดำเนินการผ่านคุณสมบัติการตรวจสอบ
Parameter นี้สามารถระบุ Package สำหรับ JPS ใดก็ได้ เช่น ตรวจสอบตัวอย่าง YAML ด้านล่าง:
type: install
name: Validation
nodes:
 image: alpine
 nodeGroup: cp
 count: 2
 validation:
   minCount: 2
   maxCount: 3
   scalingMode: stateful
เมื่อดำเนินการครบแล้วคุณสามารถใช้ auto-clustering solutions ที่รองรับโดย Ruk-Com Cloud ได้อย่างง่ายดาย